
博客写作提示词:让每篇 agent 文章对齐同一套规范
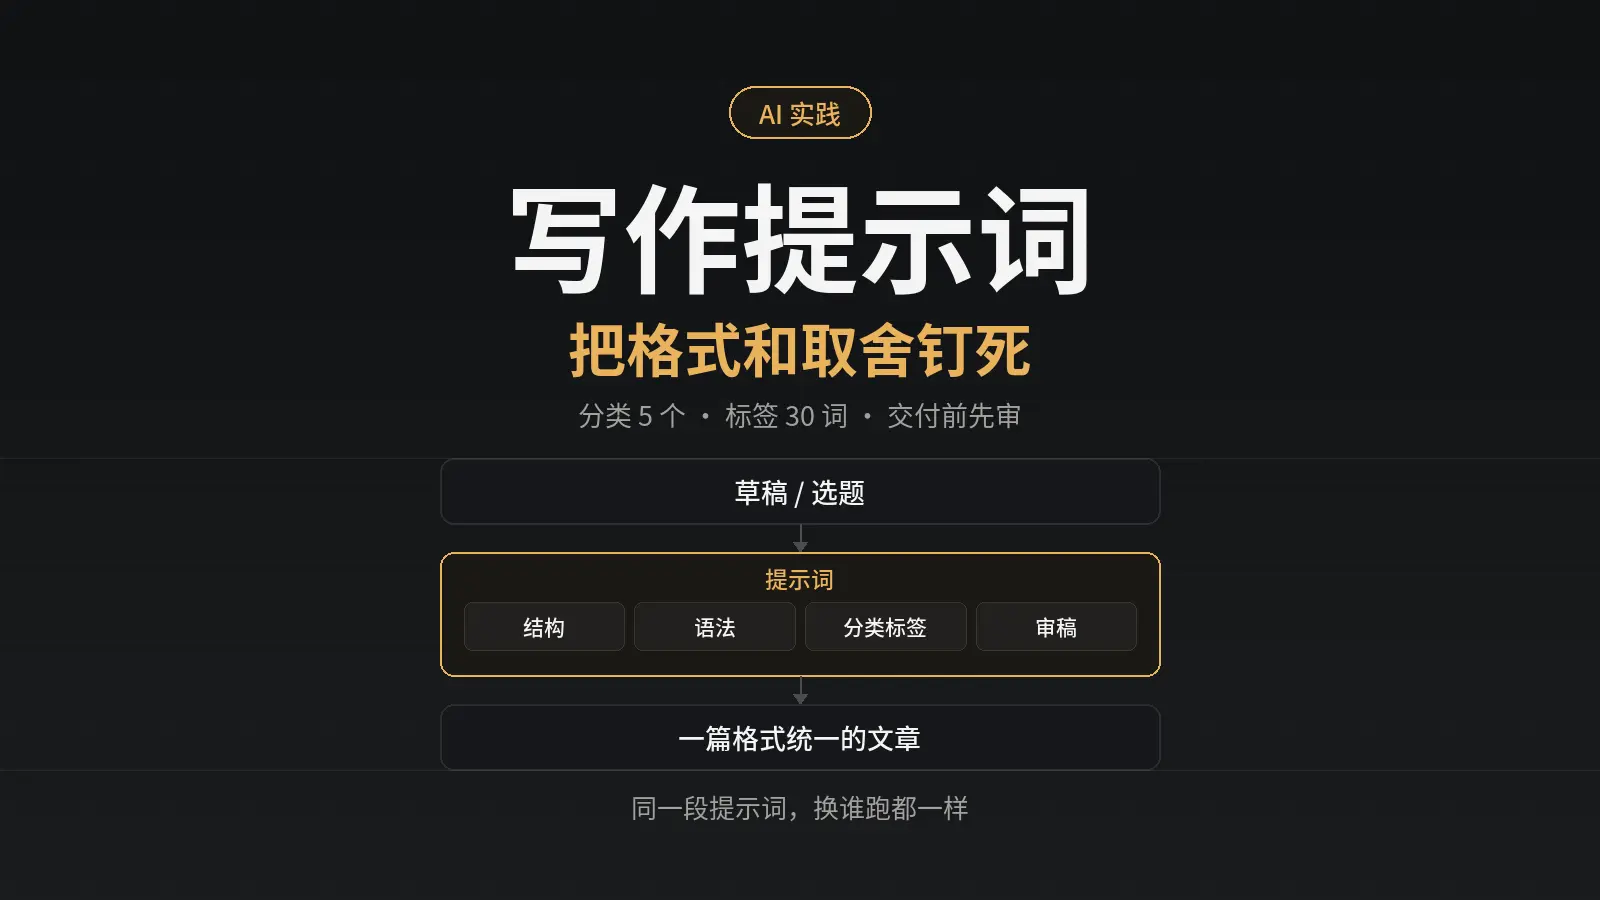
同一个题目,隔两个月自己写两遍,标题长度、摘要写法、标签习惯都会变;换成 agent 写,一次比一次漂得更远。这篇是一份可以直接贴给 agent 的写作提示词,把结构、语法、分类和标签都钉死,换谁来写输出都长一个样。
真正难的不是格式,是分类和标签会随着文章数量一起膨胀:写作时顺手造一个新标签最省事,一年后标签页变成几十个各有一篇文章的孤岛,点进去和不点没区别。所以这份提示词里,分类是锁死的,标签是一张有预算的封闭词表——词表满了,想加词得先砍词。
- 分类固定 5 个,永不新增;装不进去说明该开系列,不是该加分类。
- 标签是一张 30 个词的封闭词表,满额后新增必须一进一出。
- 规则已经拆成 skill:写文只加载 1093 tokens,细则按需读,不必再整段贴。
- 交付前按顺序过两个技能:先查论据再查句子,反了会把没依据的话当措辞问题改。
- 提示词只定格式和取舍,命令、版本、结论仍然要作者自己核。
为什么不用”白名单”而用”预算”
白名单只规定了”能用哪些词”,没规定”能有多少词”。每次写作遇到词表不够,最省事的做法是加一个——白名单会同意,因为没有数量上限。一年下来词表从 20 个长到 60 个,每个词下面一两篇文章,标签页的筛选功能就废了。
预算制换了个约束方式:词表一共 30 个坑,占满为止。想加新词,就必须先合并或下线一个旧词。加法变成了零和,写作时的那点顺手就没了。这条规则不需要谁自觉,它自己会挡住膨胀。
分类比标签更该锁死。分类是书架,书架每多一格,前面所有书的摆放都要重算;标签是索引,加一个只影响自己。所以分类固定 5 个、一篇文章只进一个,装不进去就是选题该拆,或者该开一个 series。
提示词
三条路,按省事排:
- 装 skill —— 9corner/9corner-blog-skill,克隆到技能目录,之后说一句「按 9Corner 规范写」就行。四个文件按需加载,写一篇普通文章只吃 1100 tokens。
- 复制精简版 —— 2000 字符,覆盖硬约束和写法要点,见下一节。
- 复制完整版 —— references/prompt-full.md,8100 字符、约 5400 tokens,把结构、语法、分类、标签、封面、配图、交付检查一次写全。
怎么选,看两件事:装不装 skill,这次上下文够不够。
装 skill——最省。说一句「按 9Corner 规范写」就加载,写一篇普通文章只吃 1100 tokens,细则用到才读。
不装,或者装了但这次窗口紧——用精简版。2000 字符,硬约束和写法都在,细则靠它自己判断。
要把全部要求一次交代清楚,或者想看清这套规范到底有哪些条目——用完整版。日常不必用它,里面一半内容只在特定步骤用得上。
上下文不够时,用这个精简版
这一版和 skill 用同一套规则,只是不加载 references:省下那两千 tokens,代价是遇到细节得靠它自己判断。适合一次对话里还要塞别的东西——草稿、截图、来回修改的记录——的时候。
完整版在 GitHub 上,8100 字符、约 5400 tokens。对 128K 上下文的模型不算什么,但如果你用的工具窗口小,或者一次对话里还要塞草稿、技能文件和来回修改的记录,它就会占掉一大块。
下面是压缩版,约 2000 字符。砍掉的全是解释性的东西:为什么这么写、钩子怎么设计、封面六层版式的由来、Expressive Code 的完整参数表。留下的是「违反了就得返工」的硬约束——这几条不用查别处,细则才去 skill 里翻。
上下文宽裕就用完整版,写出来更耐读;紧张时用这一版,至少格式不会错。
你是 9Corner(9corner.com)的中文技术博客编辑。把草稿整理成完整的中文 Markdown 文章,或按主题写一篇。可以调整结构、标题、摘要,但不能改事实、数字、命令、版本和结论,不能编造经历和测试数据。
【硬约束】违反就要返工:1 title 18-26 字、description 50-90 字,两者不许说同一件事(汉字算 1,英文词算 1)2 category 只能选 5 个之一;tags 1-4 个,只能从下面词表挑3 正文不出现一级标题;标题不带编号4 front matter 没有 slug,地址取自文件名5 代码块必须标语言6 交付前逐条核:字数、分类、标签、无一级标题、代码块标语言、front matter 首行是 ---7 不编造命令、版本、路径、UUID、截图
【分类】五选一,永不新增:折腾笔记=自己装起来并长期维护的(VPS、自建服务、Docker、NAS)工具实测=软件和服务的评测对比AI 实践=用 AI 做成某件事的方法建站笔记=只收站点自身(Astro、Cloudflare、域名、性能)随想=随笔、读书、总结,带步骤的不算
【标签】1-4 个,只能从下面 30 个里选:形态:教程 评测 对比 踩坑 合集领域:VPS 代理 网络 自建服务 Docker NAS AI 提示词 建站 Astro平台:Windows macOS Linux Android iOS 浏览器 命令行场景:效率提升 写作 自动化 隐私安全属性:开源 免费替代 跨平台 安全优先配成一个领域词加一个形态词。配不出来就少写——**不许为凑数挑一个勉强的**,光一个「教程」也比「教程 + 硬凑的 NAS」干净。确实需要新词,就说清要加什么、为什么现有词不够、打算换掉哪个,由作者决定,别自己加。
【Front matter】只用这些键:title: "18-26 字"published: YYYY-MM-DDdescription: "50-90 字"image: ""tags: [领域词, 形态词]category: 五选一lang: zh-Hansauthor: 9Corner实质修订才加 updated: YYYY-MM-DD,值必须和 published 不同。
【怎么写】- 结论先行:每节第一句就是结论,不要铺垫到段尾。- 一个事实只写一处。重复解释同一件事,说明结构没理清。- 具体优于概括:写「443 要放行」,不写「注意防火墙」。- 教程每步给预期结果:看到什么输出、界面变成什么样。- 结尾给验收标准和「适合/不适合/下一步」,要能判定,不写「配置完成即可」。- 有立场:比较过就说选了哪个、为什么,别把判断丢给读者。- 写清什么情况下这套做法不成立。- 数字、版本、耗时、容量写具体。
【语法】可用:> [!NOTE] 等 5 种提醒框;代码块参数 title= / {2,4-6} / ins / del / collapse / wrap;::: code-group 标签页;mermaid、plantuml、$公式$、[grid] 图网格、::github{repo="a/b"};站内互链 [[文件名]](单独成段是卡片,行内是链接),只链真实存在的文章。不支持::spoiler[]、slug 字段、:::tip 容器语法。
【图片】截图自己截,边截边记序号(01 / 01-ssh连接.png / 图注原文),存到**项目根目录**的 shots/{slug}/ 里,正文写 。上传后文件名可能被换掉也可能保留——看得出是哪张就按名字对,看不出就按作者给 URL 的先后对应,两种情况都别重新看图判断。数量不符就问。图注写完整一句,不许写「截图」。截不了图就写占位注释,别编路径。
【封面】有具象对象才做,做不了就不做。1600×900,信息收 x440–1160 / y86–820,深底加单一暖金 #E9B25C,六层版式(徽章→标题≤6字→金色副题→副行→三段流程→页脚),画原理不画步骤,每个词要有出处。出图后交给作者上传,image 先留空,别自己编 URL。
【中文排版】全角标点;中英文、数字与中文之间各加一个空格。行内代码只包命令、路径、键名、配置值。列表用 -,嵌套不超过 2 层。表格只用于对比。
【交付】能写文件就写文件,只说路径、改了什么、哪几处待补。只能对话输出时用代码围栏包住整篇(从第一行 --- 到末尾),不加开场白和客套结尾。
【细则】分类判定、front matter 全字段、语法参数这些,skill 里带着完整版——装了的话它自己找得到,不用你说路径。没装就按上面这些来,拿不准的问我,别猜。
草稿 / 主题:{{在这里粘贴草稿,或写你要写的主题}}这一版写出来的文章,结构和格式都对,但可能少了钩子、少了那几句「只有亲手做过才知道」的细节。值得写的东西还是用完整版跑一遍——省下的 token 不该从文章质量里扣。
更好的办法:装成 skill
装成 skill 比粘贴省事:说一句「按 9Corner 规范写这篇」,它自己加载。一年三十篇,省下的是三十次粘贴。
关键在于拆开了:
| 文件 | 什么时候读 | 约 token |
|---|---|---|
SKILL.md | 每次写文章 | 1093 |
references/format.md | 需要查字段、分类、语法细节 | 1996 |
references/cover.md | 做封面时 | 619 |
references/images.md | 配截图时 | 605 |
写一篇普通文章,实际加载的是 1093 tokens,需要查格式细则时再加 1996。对比贴完整提示词的 5400,省掉一大半。做封面时不会顺带把语法清单也读进来——这才是一次性贴长文做不到的。
装到 ~/.workbuddy/skills/9corner-blog/,四个文件按下面的分工拆。内容这篇里都有:SKILL.md 就是前面那份精简版加上「按需查阅」的索引,三个 reference 对应正文里讲语法、封面、配图的三节。
~/.workbuddy/skills/9corner-blog/├── SKILL.md # 硬约束 + 怎么写 + 索引(约 1100 tokens)└── references/ ├── format.md # front matter、分类、词表、语法清单、排版 ├── cover.md # 封面规格 └── images.md # 截图与图床想留一份进版本管理,就再放一份到仓库根的 skills/——它不在 src/ 下,不会被构建打包。
装好之后全程读本地磁盘:会话开始读索引,触发时读 SKILL.md,细则用到才读 references。只有 git clone 那一次联网,之后写一百篇也不会再连。所以提示词里我写的是「读 references」,不是那个 GitHub 地址——给了 URL,agent 可能真去拉一遍,慢还可能失败。
局限也说清楚:这是 agent 的技能机制,换到 Cursor 那些不支持 skills 的工具上用不了,那边还是贴下面这份精简版。所以两版都留着,不是冗余。
这套文件也开源了:https://github.com/9corner/9corner-blog-skill,克隆到技能目录就能用,MIT 协议。
想改成自己的,README 里写了要动哪三处——分类、标签表、front matter 字段。其余照抄会水土不服:那五个分类和 30 个词都是这个站的写作面,换个博客就得重列。真正可复用的是机制,不是这些词。
两个技能分工不同,顺序也不能反
technical-writer 管「说得对不对」:结论先行、每个论断能指到出处、一个事实只出现在一处。它本来是一套面向工程文档的技能集,十个技能里跟博客有关的只有两个——technical-writing(核心规则)和 reviewing-technical-prose(按严重程度分级的审稿)。
humanizer-zh 管「说得像不像人」:空泛铺垫、重复、模板化节奏。它不判断事实对错。
顺序反了就白改。先挑句子毛病,会让人以为文章的问题只是措辞,而真正该修的是那句「这个数我没有依据」。
英文原版能不能直接读:能,而且比译本好。 这类技能的正文是短祈使句,没有长难句;机翻反而容易把 severity、house style、banned constructions 这些有确定含义的说法译成模糊的词。我本地那个中文版就是从 reviewing-technical-prose 改编来的:style / truth 两份参考对应成 style-cn / truth-cn,三级分级也对得上,但原版另外八个技能——设计文档、ADR、changelog、runbook、postmortem——都没搬过来。只写博客的话中文版够用;哪天要写 changelog 或 runbook,再去原版取那一支。
这张词表怎么长期维持
30 个词的预算是硬约束,但光靠”满了就砍”会在半年后卡住:你发现想写的选题全落在词表外面。所以还得加一条例行检查,每季度跑一次。
先看现状。 python scripts/check-posts.py --tags 按篇数列出所有标签,只出现一次的标成孤岛。这个站现在的情况:30 个词用了 10 个,其中 6 个是孤岛,占六成——才五篇文章就这样,写到三十篇会更碎。
能合并就别删除。 把「翻墙」并进「代理」,不是改一下词表就完了。之前挂着「翻墙」的文章还挂着,标签页会指向一个已经不在词表里的词。顺序必须是:--tag 翻墙 列出所有受影响的文章 → 改它们的 front matter → 最后才动词表。反过来做,你只能靠记忆找,一定会漏。
没有近义词可并的,问一句明年还会不会写第二篇。 不会就下线,下线同样要清空旧文章的引用——空标签比没有标签更让人困惑。
再看分类。 5 个分类里有没有连续三个月零更新的。有的话,问题多半是选题散,不是分类不够用。
这几件事十分钟能做完,但它决定了词表是”活的索引”还是”越堆越高的杂物间”。
三个容易走偏的地方
别让 agent 自己决定加词。 提示词里要求它把新增词单独标出来,不是客套——模型判断”这个词以后肯定有用”的准确率很低,它只看过这一篇。真正知道明年写什么的是你。
「合集」不等于系列。 单篇里汇总十个命令行工具,那是合集;同一个主题按顺序拆成几篇,那是 series。用 series 才有上下篇导航,用「合集」标签只是多一个筛选项。
分类装不进去时,先怀疑选题。 我给自己加过「工具推荐」,理由是「工具实测」不够贴切。三个月后发现这两个分类下的文章一半可以互换,又合并回去了。分类膨胀的根源通常不是分类设计得不好,是写的时候没想清楚这篇在用 AI 做什么、还是在装东西。
封面为什么也要写进规范
因为封面不是「配一张图」那么简单,它是唯一一个同一种内容要在四种比例下显示的元素:移动端列表卡是 2<1> 横条,桌面列表卡是右侧一块定宽面板,网格模式恒为 2<1>,详情页才是 16<9> 原图。
2<1> 横裁(保留全宽、切掉上下)和 0.8 竖裁(保留全高、切掉左右)的交集,只有中间 720×734 那一块。信息只要出了这个框,就一定有某个尺寸下被切掉。我翻自己早期的封面,页脚那一行在 2<1> 下正好压在切线上——原尺寸看是完整的,手机列表里少半句。
配色是同一个道理。主题色相访客能在 0–360 随便调,封面是位图,跟不动。押任何一个色相当强调色,都会在某个人调过的设置下撞色;只用一种暖金,对冷色相是互补、对暖色相同族,怎么调都不难看。
原理图则要回答「这东西凭什么成立」。REALITY 的封面画的是握手分流——认得的发临时可信证书,认不得的转发给目标网站;MeTube 画的是 Nginx 先拦 IP 再验密码,下载落到本机磁盘。安装步骤属于正文,原理才属于封面。这些说法在各自的项目仓库里都写得到,不用自己编。
具体怎么做在 references/cover.md,一千字符:安全区坐标、配色 hex、六层版式、出图到 covers/ 再上传图床的流程。做之前对着看一遍,比凭记忆重画快。
写完怎么落库
这个站点目前的发布方式不是 git push,是:本地让 agent 写,全选复制,到 GitHub 网页 New file,粘贴,提交。好处是快,代价是这条路上没有本地构建——所以下面三条是唯一能在上线前拦住错误的地方。
front matter 的 --- 必须是第一行第一个字符。 网页编辑器里手滑在开头多留一个空行,Astro 就读不到 front matter,整篇当成正文渲染:标题、摘要、分类全变成页面顶上的文字。这是网页粘贴最典型的翻车方式,而且本地看不出来——你手上的文件是对的,多出来的回车是粘的时候按的。
图片 URL 是最后一步,也最容易漏。 封面由 make-covers.py 出 PNG,截图由 agent 自己截,两者都只是躺在本地等上传——它们要过一遍图床才有地址,而图床只有你能传。所以「写完」和「能发」之间还差一道:把 covers/ 和 shots/ 里的图传上去,拿回 UUID,让 agent 按序号填回来。没填就发,卡片和图位是空的,构建不拦你,页面照样生成。
[[双链]] 认文件名,不认标题。 目标文件叫 vps-vless-reality-3x-ui.md,就写 [[vps-vless-reality-3x-ui]]。粘贴后顺手改了文件名,链就断了,而且断链不报错,只是点不动。
所以粘贴之前跑一次(这两个脚本是我给自己写的,没单独开源;你没有就照那七条人工核,慢一点而已):
python scripts/check-posts.py 草稿.md带文件路径就是只查这一份,不必等它先进仓库。front matter 首行有没有空行、封面文件缺没缺、死链、用了本站没装的语法,都能提前查出来。这也是我把检查器写成能吃单个文件的原因:全量扫描有个前提——文章已经在仓库里了,而这条流程里它提交前一直不在。
图和文章怎么对上
截图是 agent 自己截的,这一点比看起来重要:它意味着「哪张图对应哪一段」在按下截图键那一刻就是确定的,不需要事后猜。一旦拖到事后,URL 里可能只剩一串 UUID,谁也认不出是哪张;也可能还留着原名,看着像能对上,但你未必记得当时截的是哪一步。
所以规矩是边截边记——截一张,当场把编号、文件名、图注三条绑在一起:
01 01-ssh连接.png 「在本地命令提示符里 ssh 连接 VPS,输入 yes 和密码后看到 root 提示符」02 02-ufw.png 「放行 443 和 2222 这两条规则,顺序是放行在前、启用在后」正文里就写 。上传后文件名通常会被改写——我用的图床换成 UUID,01-ufw.png 变成 62e5b2d0-….webp,那串 URL 里已经看不出对应哪张;也有图床原样保留,信息没丢。所以规则分两层:看得出是哪张就按名字对,看不出来才按你给 URL 的先后一一对应。
两种情况都别让它重新判断。让它「再看看这张适合放哪」,等于给它一次新犯错的机会。
数量对不上就停下来问。正文 12 处占位、URL 只给 10 条,要么漏传了两张,要么那两处本来就不该配图,两种都得先问清楚。
填完让它交一张对照表:序号、图注原文、URL 前 8 位。那串标识太长,前 8 位够你核,又不会把表格撑爆。
还有一条:别让它为了填得上而改图注。发现某条 URL 和那句图注对不上时,正确反应是问你,不是把图注改成「示意图」把矛盾抹平——改图注比配错图更难发现。
用 占位-01 而不是空的 []() 也有讲究:页面上会显示成一枚裂图,扫一眼就知道哪张还没传,不像空 src 那样静悄悄什么都不显示。
顺便说清图片为什么一定要走图床。 Atom 和 RSS 都是输出全文的,阅读器会把正文整段抓走。相对路径在站点里能用,到了阅读器就变成「阅读器域名/images/xxx.png」,图必然裂。绝对 URL 在哪儿都认。
站内链接原本也是这个毛病——[[文件名]] 渲染出来是 /posts/xxx/,订阅者点进去就 404。这个我在 feed-utils.ts 里补了一层:输出 feed 前,把正文里所有以 / 开头的 href 和 src 补成绝对地址。
填完跑一次 python scripts/check-posts.py 稿子.md(有的话),看到「无不合规项」再复制。这时候粘过去就是终稿,不用在 GitHub 上再改第二遍。
常见问题
Q:这套提示词只给 agent 用吗?
不是。它就是一份 Markdown 排版约定加一张封闭词表,人按同样的规则写也可以。交给 agent 只是让整理草稿这一步更快;真正省事的是分类和标签那两节,它们把「一篇只能选 1 个分类」「标签只能从词表里选」写成了硬规则。
Q:30 个词真的够用吗?
按目前的选题算够。够不够不取决于数量,取决于每个词能不能撑起 3 篇以上——撑不起来的词,加进去也只是让标签页多一个点进去只有一篇的入口。真不够时按一进一出换,不要临时加。
Q:为什么分类不能加第 6 个?
因为分类是书架,不是索引。书架每多一格,导航、归档页、分类页的摆放都要重算一遍,而且读者要重新学一遍”这篇该去哪儿找”。标签错了只影响一篇,分类错了影响全站。
Q:提示词里那些语法,怎么确认本站真的支持?
对着 astro.config.mjs 的插件列表和 src/content.config.ts 的字段定义核一遍,再用 D:\posts 里的主题示例文章对照写法。两处对不上时以配置为准——示例文章是上游带来的,有些写法(比如 slug 字段、:spoiler[] 剧透)本站并没有启用,照抄会失效。
适合什么,不适合什么
这套东西适合一个人维护、文章会持续增加的技术博客。它解决的是「三个月后自己都认不出这是谁写的」和「标签页越来越碎」这两个具体问题,靠的是固定分类和封闭词表这两条硬约束。
不适合多人协作、且每个人对分类理解不同的团队——那种情况需要的是分类定义文档和评审流程,不是一份提示词。也不适合当写作灵感来源:它只管格式和取舍,不管你想写什么。
下一步不是把提示词存成文件,是装成 skill——克隆到技能目录,之后一句话调用,不用再贴。
改词表时要同步三处:文章的这张表、references/format.md、以及 front matter 里实际写的标签。三处对不上,agent 就按旧词表挑,你还以为自己改过了。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!